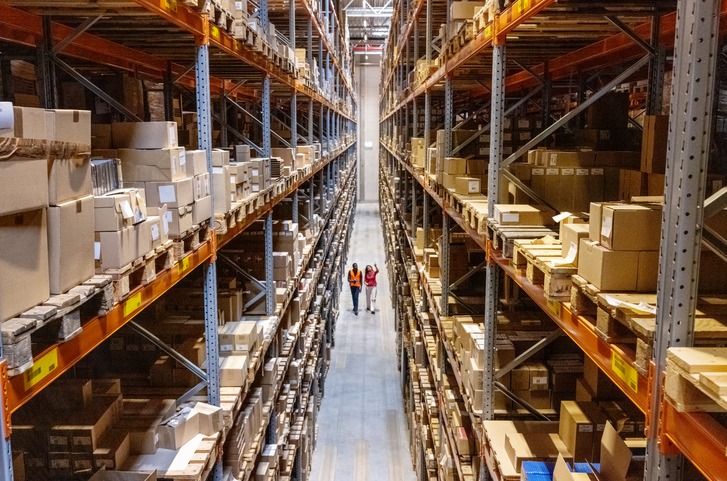
Piloter un réseau composé de plusieurs entrepôts, magasins ou dépôts régionaux transforme radicalement les enjeux de la gestion de la chaîne d’approvisionnement. Ce qui fonctionne parfaitement pour un site unique s’effondre souvent dès que les flux se multiplient. Chaque site doit être approvisionné au bon moment, sans excès ni rupture, et cet équilibre devient rapidement un véritable exercice d’équilibriste pour les équipes logistiques.
Dans cet article, nous passons en revue les défis propres à la prévision de la demande à l’échelle d’un réseau multi-sites, ainsi que les leviers concrets pour bâtir une gestion efficace de vos flux et de vos stocks.
Pourquoi la prévision multi-sites est plus complexe qu’il n’y paraît ?
Sur un site unique, la demande suit généralement une logique assez lisible : historique de ventes, saisonnalité, tendances locales. Dès que plusieurs points de vente ou de stockage entrent en jeu, cette logique se fragmente immédiatement.
Chaque site possède en effet son propre profil de consommation. Un entrepôt situé près d’une grande métropole n’absorbe pas les mêmes volumes qu’un dépôt rural. Par conséquent, appliquer un modèle de prévision unique à l’ensemble du réseau produit des écarts importants, parfois dans les deux sens : surstock d’un côté, rupture de l’autre.
De plus, les interdépendances entre sites compliquent encore l’exercice. Un transfert de stock entre deux entrepôts, une promotion locale ou un événement ponctuel dans une région peuvent influencer la demande d’un site voisin. Ignorer ces interactions revient à prévoir chaque site en vase clos, ce qui fausse mécaniquement les résultats et nuit à la prise de décision.
Les défis concrets d’un réseau de distribution
Une fragmentation des données difficile à corriger
Le premier obstacle est presque toujours le même : les données sont dispersées. Chaque site utilise parfois son propre outil, son propre tableur ou sa propre méthode de saisie. Résultat : impossible d’obtenir une vision consolidée sans un travail manuel important, ni même une gestion de données fiable au niveau du siège.
C’est précisément là qu’intervient la centralisation des données. En regroupant les informations issues de tous les sites dans un système unique, l’entreprise obtient enfin une base fiable pour construire ses prévisions. Sans cette étape, tout modèle statistique, aussi sophistiqué soit-il, repose sur des fondations bancales. Les logiciels de gestion modernes permettent justement d’automatiser cette remontée d’information, site par site, sans intervention manuelle chronophage.
Des niveaux de granularité à concilier
Un réseau multi-sites impose de raisonner à plusieurs échelles simultanément : la demande globale du réseau, celle de chaque région, puis celle de chaque site individuel. Or, une prévision agrégée au niveau national masque souvent des disparités locales majeures.
Ainsi, il devient nécessaire de descendre au niveau le plus fin possible, tout en gardant une cohérence avec la vision globale. C’est un arbitrage permanent entre précision locale et cohérence d’ensemble, qui conditionne directement la fiabilité des niveaux de stock affichés dans les tableaux de bord.
Une gestion des stocks plus exigeante
Avec plusieurs sites, la question n’est plus seulement « combien commander », mais aussi « où stocker » et « comment répartir ». Un excédent dans un entrepôt ne compense pas automatiquement une pénurie dans un autre, sauf si des mécanismes de transfert sont prévus en amont. Une gestion des stocks rigoureuse devient alors la pierre angulaire de toute stratégie multi-sites.
L’optimisation entrepôt logistique joue ici un rôle central. Elle permet de mieux répartir les stocks entre les sites, de réduire les coûts de stockage inutiles et de limiter les transports d’urgence, souvent coûteux et peu écologiques. Elle facilite aussi le travail quotidien des préparateurs de commandes, qui disposent d’informations plus fiables sur la disponibilité réelle des articles.
Des délais d’approvisionnement variables
Selon la localisation d’un site, les délais de livraison des fournisseurs peuvent varier sensiblement. Un dépôt proche d’un fournisseur clé bénéficie d’un réapprovisionnement rapide, tandis qu’un site plus isolé doit composer avec des délais plus longs et donc des stocks de sécurité plus élevés.
Négliger cette variabilité conduit à des prévisions théoriquement correctes, mais inapplicables sur le terrain. C’est souvent à ce niveau que se joue la véritable performance d’une chaîne logistique : anticiper les délais plutôt que de les subir.
Comment fiabiliser la prévision de la demande à l’échelle du réseau ?
Miser sur une donnée unifiée et actualisée
Avant même de parler de modèles prédictifs, il faut sécuriser la donnée. Cela passe par des outils capables de consolider automatiquement les flux issus de chaque site : ventes, stocks, ruptures, retours. Une donnée à jour, fiable et partagée constitue le socle de toute prévision pertinente et de toute gestion efficace du réseau.
La mise en place de ce socle technique demande du temps, mais elle change radicalement la donne. Une fois l’information centralisée, les équipes gagnent un temps précieux et peuvent enfin se concentrer sur l’analyse plutôt que sur la collecte.
Segmenter les sites selon leurs caractéristiques
Tous les sites ne se ressemblent pas. Segmenter le réseau par typologie urbain, périurbain, rural, saisonnier, permet d’appliquer des modèles de prévision adaptés à chaque profil, plutôt qu’une méthode unique inadaptée à la diversité du terrain.
Cette segmentation améliore directement la satisfaction des clients : un site correctement approvisionné livre plus vite, propose davantage de produits disponibles, et limite les ruptures qui frustrent les acheteurs. À terme, c’est toute l’expérience client qui en bénéficie.
Intégrer les événements locaux dans les modèles
Une prévision purement statistique ignore souvent les événements ponctuels : opérations commerciales locales, travaux, conditions météorologiques ou concurrence nouvelle. Intégrer ces variables, même de manière qualitative, améliore sensiblement la fiabilité des prévisions et sécurise la prise de décision des équipes achats et logistique.
Automatiser les ajustements entre sites
Enfin, un réseau performant s’appuie sur des règles de réapprovisionnement inter-sites automatisées. Lorsqu’un site approche d’une rupture, le système doit pouvoir déclencher un transfert depuis un site voisin en excédent, sans attendre une intervention manuelle.
Mettre en place ce type d’automatisation demande généralement l’appui de logiciels de gestion capables de dialoguer entre eux, mais le retour sur investissement est rapide : moins de ruptures, moins de surstocks, et une réduction des coûts logistiques mesurable dès les premiers mois.
Les bénéfices d’une chaîne d’approvisionnement pilotée en réseau
Une fois ces fondations posées, les gains dépassent largement la seule prévision de la demande. Une chaîne d’approvisionnement bien pilotée à l’échelle du réseau permet de :
- Réduire les stocks dormants tout en évitant les ruptures ;
- Diminuer les transports d’urgence entre sites ;
- Améliorer la visibilité globale pour la direction et les équipes terrain ;
- Renforcer la réactivité face aux aléas de marché ;
- Soutenir une croissance du réseau sans complexifier excessivement les processus.
Ces bénéfices ne se limitent pas au court terme. Ils s’inscrivent dans une logique de long terme : un réseau capable de prévoir sa demande avec précision devient plus résilient face aux crises d’approvisionnement, aux variations saisonnières et à l’évolution des habitudes de consommation.
Vers une gestion de la chaîne d’approvisionnement plus résiliente
La prévision de la demande multi-sites n’est pas qu’un enjeu technique. Elle conditionne directement la satisfaction client, les coûts logistiques et la capacité de l’entreprise à absorber les aléas du marché. C’est un pilier essentiel d’une gestion de la chaîne globale, cohérente et pilotée par la donnée.
En combinant centralisation des données, segmentation fine des sites et optimisation entrepôt logistique, les réseaux de distribution gagnent en réactivité. Ils réduisent leurs ruptures, limitent leurs surstocks et transforment une gestion subie en un véritable avantage compétitif.
La mise en œuvre d’une telle démarche ne se fait pas du jour au lendemain. Elle demande d’impliquer les équipes de chaque site, de choisir des outils adaptés et d’accepter une phase de calibrage progressif des modèles de prévision. Mais les entreprises qui investissent aujourd’hui dans ces fondations construisent un réseau capable d’anticiper la demande, plutôt que de simplement la subir et posent les bases d’une gestion efficace de la chaîne pour les années à venir.
À terme, c’est l’ensemble de l’organisation qui y gagne : des équipes logistiques moins sous tension, des préparateurs de commandes qui travaillent avec des données fiables, et des clients mieux servis, partout où le réseau est implanté.
Par où commencer concrètement ?
Face à l’ampleur du chantier, beaucoup d’entreprises hésitent sur le point de départ. La meilleure approche consiste généralement à avancer par étapes plutôt que de vouloir tout transformer d’un coup. Un audit initial des sources de données existantes permet d’abord d’identifier les écarts entre sites et les outils déjà en place qui pourraient servir de socle à la centralisation.
Ensuite, un projet pilote sur deux ou trois sites représentatifs offre un terrain d’essai idéal avant un déploiement à l’échelle du réseau entier. Cette phase pilote permet d’ajuster les modèles de prévision, de former les équipes locales et de mesurer les premiers gains, qu’il s’agisse de la baisse des ruptures ou de la diminution des transferts d’urgence entre sites.
Enfin, il est essentiel d’associer les équipes terrain à chaque étape. Ce sont elles qui connaissent le mieux les spécificités de leur site, et leur retour d’expérience affine considérablement la pertinence des modèles statistiques. Une démarche descendante, imposée sans concertation, se heurte presque toujours à des résistances qui ralentissent l’adoption des nouveaux outils.
Structurée ainsi, la transformation devient progressive, mesurable, et surtout durable : chaque étape franchie consolide la suivante, jusqu’à obtenir un réseau véritablement piloté par la donnée.